虛擬化災備原理與實現手段(三) 基于虛擬化的災備恢復實踐
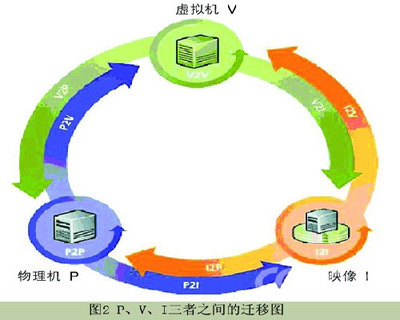
在企業IT架構中,虛擬化技術的普及不僅提高了資源利用率,也為災備(災難恢復)帶來了新的思路。前面兩篇分別介紹了虛擬化災備的基本概念和核心技術,本文聚焦于實際落地環節——如何利用虛擬化平臺構建高效、可靠的災備恢復方案,并探討常見實現手段與注意事項。
一、虛擬化災備的恢復模式
基于虛擬化環境的災備恢復,通常可分為三種模式:
- 冷恢復(Cold Recovery):災難發生后,從備份中恢復虛擬機文件,并在備用主機上重新啟動。這種方式恢復時間較長(RTO較高),但成本低、實現簡單。
- 溫恢復(Warm Recovery):預先在備用站點部署好虛擬化主機和部分基礎架構,但虛擬機處于關閉狀態。災難時快速恢復電源并啟動,RTO適中。
- 熱恢復(Hot Recovery):利用存儲復制或虛擬化集群技術,備用站點的虛擬機保持運行或實時同步狀態,可實現分鐘級甚至秒級切換。RTO與RPO極低,但成本最高。
企業需要根據業務關鍵性,對不同應用采用不同恢復模式,實現成本與風險的平衡。
二、利用快照與備份實現災備
虛擬機快照是虛擬化特有的便捷保護機制,但并不等同于備份。在許多場景下,可將快照與備份軟件結合,形成有效的虛擬化災備手段:
- 增量與差異備份:借助虛擬化平臺的變更塊追蹤(CBT)功能,僅備份自上次備份后變更的數據塊,極大減少備份窗口和存儲占用。
- 無代理備份:通過虛擬化API直接讀取虛擬機磁盤文件,無需在每臺虛擬機內安裝代理,降低管理復雜度。
- 定期驗證:在隔離環境中拉起備份虛擬機,驗證數據完整性和可恢復性。
三、復制與容災切換
對于希望實現低RTO/RPO的關鍵業務,虛擬化平臺的復制功能是常用的技術手段:
- 基于陣列的復制:由底層存儲陣列完成同步或異步復制,對虛擬機透明,性能高但需同構存儲。
- 基于虛擬化主機的復制:如VMware SRM、微軟Hyper-V Replica等,在虛擬化層完成數據復制和編排調度,可跨異構存儲。恢復時按預定義恢復計劃自動切換,減少人為操作失誤。
- 跨站點集群:通過延伸集群技術,讓虛擬機可在兩個站點間漂移。但對網絡延遲有較高要求,一般適用于同城雙活。
四、現場實踐中的關鍵考量
無論采用哪種實現手段,成功的虛擬化災備都離不開以下要點:
- 明確恢復目標:與業務部門共同確定每項應用的RTO、RPO,以此選擇技術和投資規模。
- 定期演練:至少每半年進行一次災備切換演練,發現配置偏差和流程瓶頸。
- 自動化編排:利用腳本或災備管理軟件定義啟動順序、網絡映射、IP地址轉換等,降低人工干預。
- 保護災備環境本身:備份數據至少保留一份離線副本,防范勒索軟件對備份系統的攻擊。
五、小結
虛擬化災備不是單一的某個產品,而是一套結合了復制、備份、快照和自動化切換的體系。核心根據虛擬機的特點進行數據保護和站點切換規劃。在此基礎上,后續我們將具體介紹幾款主流虛擬化管理平臺上的災備配置實例,幫助受眾快速上手實踐。
如果對本??有任何技術細節上的疑問,歡迎留言一并探討。 (作者:虛擬化技術專員,常年專注IT基礎設施及容災備份研究。)
如若轉載,請注明出處:http://m.lxtester.com/product/38.html
更新時間:2026-11-05 20:21:07